Domain lavasee.de kaufen?
Wir ziehen mit dem Projekt
lavasee.de um.
Sind Sie am Kauf der Domain
lavasee.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain lavasee.de kaufen?
Was sind effiziente Methoden zur Namensauflösung in großen Datensätzen?
Effiziente Methoden zur Namensauflösung in großen Datensätzen sind Hashing-Algorithmen, die den Namen in einen eindeutigen Hash-Wert umwandeln, um schnelle Suchvorgänge zu ermöglichen. Indexstrukturen wie Bäume oder Hash-Tabellen können verwendet werden, um den Zugriff auf die Namen zu optimieren. Parallelisierungstechniken wie MapReduce können eingesetzt werden, um die Verarbeitung großer Datensätze zu beschleunigen. **
Was sind mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen?
Mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen können menschliche Fehler bei der Dateneingabe, unterschiedliche Datenformate oder -strukturen sowie fehlende oder inkorrekte Daten sein. Auch können technische Probleme wie Datenverlust oder -korruption zu Nichtübereinstimmungen führen. Schließlich können auch unterschiedliche Zeitpunkte der Datenerfassung oder -aktualisierung zu Abweichungen zwischen den Datensätzen führen. **

Ähnliche Suchbegriffe für Datensätzen
Top-Angebote
Produkte zum Begriff Datensätzen:
-
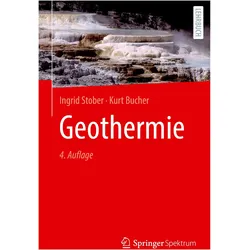
Geothermie, Fachbücher von Ingrid Stober, Kurt BucherDieses Buch vermittelt umfassend die Grundlagen und technischen Anwendungen der Geothermie als erneuerbare Energiequelle und zeigt das enorme Potenzial der Erdwärmenutzung als Grundlastenergie für eine umweltfreundliche Energieversorgung auf. Nach einer Einführung in die physikalischen und chemischen Grundlagen der natürlichen geothermischen Energie werden die wichtigsten thermischen und hydraulischen Parameter sowie alle derzeit verfügbaren geothermischen Nutzungssysteme - von oberflächennahen bis zu tiefen Geothermieanlagen - im Detail besprochen. Dies umfasst die Planung, den Bau und Betrieb von Erdwärmesonden, hydrothermalen Anlagen, Untergrundspeichern, EGS-Systemen und Hochenthalpienutzungen. Dabei liegt der Fokus sowohl auf der Effizienz als auch auf den potenziellen Umweltauswirkungen dieser Systeme. In der vierten, überarbeiteten und aktualisierten Auflage werden zudem die neuesten Entwicklungen in der Geothermie vorgestellt, wie etwa die Möglichkeiten zur Sektorkopplung durch neu entwickelte Grosswärmepumpen und die CO2-Sequestrierung in Hochenthalpie-Anlagen. Besondere Kapitel widmen sich der Hydraulik - inklusive der Durchführung und Auswertung hydraulischer Tests - der Hydrochemie, der Herkunft der Tiefenfluide, der Abschätzung von Reservoirtemperaturen mittels Geothermometern sowie den geophysikalischen Untersuchungsmethoden an der Erdoberfläche und im Bohrloch. Mit dieser Auflage wird die Geothermie erstmalig in ihrer gesamten Breite abgedeckt, und durch praxisnahe Erklärungen bietet das Buch eine wertvolle Grundlage für Forschende, Planer und Anwender im Bereich der geothermischen Energie.49,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was ist der Unterschied zwischen komprimierten Daten und komprimierten Datensätzen?
Komprimierte Daten beziehen sich auf einzelne Dateien oder Informationen, die durch einen Komprimierungsalgorithmus verkleinert wurden, um Speicherplatz zu sparen. Komprimierte Datensätze hingegen beziehen sich auf eine Sammlung von Daten, die als Ganzes komprimiert wurden, um Platz zu sparen und die Übertragungseffizienz zu verbessern. Ein komprimierter Datensatz kann aus mehreren komprimierten Dateien oder Datenbeständen bestehen, die zusammengefasst wurden. **
-
Welche Methoden können zur Analyse von komplexen Datensätzen verwendet werden?
Zur Analyse von komplexen Datensätzen können Methoden wie statistische Analysen, maschinelles Lernen und Data Mining eingesetzt werden. Diese Techniken helfen dabei, Muster, Trends und Zusammenhänge in den Daten zu identifizieren. Durch Visualisierungen und Datenvisualisierungstools können die Ergebnisse verständlich und anschaulich dargestellt werden. **
-
Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Kompressionsalgorithmen und die Auswahl relevanter Merkmale. Durch diese Maßnahmen kann die Datenmenge reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dadurch wird die Verarbeitungsgeschwindigkeit verbessert und der Speicherplatzbedarf verringert. **
-
"Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?"
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Dimensionalitätsreduktionstechniken wie PCA und die Nutzung von Clustering-Algorithmen zur Identifizierung von repräsentativen Datenpunkten. Es ist auch wichtig, Ausreißer zu identifizieren und zu entfernen, um die Qualität der Daten zu verbessern und die Effizienz von Analysen zu steigern. Letztendlich sollten die gewählten Methoden darauf abzielen, die Datenmenge zu reduzieren, ohne dabei wichtige Informationen zu verlieren. **

Was sind die wichtigsten Aspekte beim Monitoring von großen Datensätzen?
Die wichtigsten Aspekte beim Monitoring von großen Datensätzen sind die Überwachung der Datenintegrität, die Performance des Systems und die Sicherheit der Daten. Es ist entscheidend, potenzielle Fehler frühzeitig zu erkennen, um Auswirkungen auf die Datenqualität zu minimieren. Zudem sollte das Monitoring kontinuierlich erfolgen, um eine effiziente Verarbeitung und Analyse großer Datenmengen sicherzustellen. **
Wie können Abweichungen in großen Datensätzen erkannt und interpretiert werden?
Abweichungen in großen Datensätzen können durch statistische Analysen wie Ausreißererkennung und Clusteranalyse identifiziert werden. Zudem können Data-Mining-Techniken wie Anomalieerkennung und Mustererkennung eingesetzt werden, um ungewöhnliche Muster oder Trends zu erkennen. Die Interpretation der Abweichungen erfordert in der Regel Fachwissen und Kontextwissen, um die Ursachen und Auswirkungen der Abweichungen zu verstehen. **
Top-Angebote
Produkte zum Begriff Datensätzen:
-
Geothermie, Fachbücher von Ingrid Stober, Kurt BucherDieses Buch vermittelt umfassend die Grundlagen und technischen Anwendungen der Geothermie als erneuerbare Energiequelle und zeigt das enorme Potenzial der Erdwärmenutzung als Grundlastenergie für eine umweltfreundliche Energieversorgung auf. Nach einer Einführung in die physikalischen und chemischen Grundlagen der natürlichen geothermischen Energie werden die wichtigsten thermischen und hydraulischen Parameter sowie alle derzeit verfügbaren geothermischen Nutzungssysteme - von oberflächennahen bis zu tiefen Geothermieanlagen - im Detail besprochen. Dies umfasst die Planung, den Bau und Betrieb von Erdwärmesonden, hydrothermalen Anlagen, Untergrundspeichern, EGS-Systemen und Hochenthalpienutzungen. Dabei liegt der Fokus sowohl auf der Effizienz als auch auf den potenziellen Umweltauswirkungen dieser Systeme. In der vierten, überarbeiteten und aktualisierten Auflage werden zudem die neuesten Entwicklungen in der Geothermie vorgestellt, wie etwa die Möglichkeiten zur Sektorkopplung durch neu entwickelte Grosswärmepumpen und die CO2-Sequestrierung in Hochenthalpie-Anlagen. Besondere Kapitel widmen sich der Hydraulik - inklusive der Durchführung und Auswertung hydraulischer Tests - der Hydrochemie, der Herkunft der Tiefenfluide, der Abschätzung von Reservoirtemperaturen mittels Geothermometern sowie den geophysikalischen Untersuchungsmethoden an der Erdoberfläche und im Bohrloch. Mit dieser Auflage wird die Geothermie erstmalig in ihrer gesamten Breite abgedeckt, und durch praxisnahe Erklärungen bietet das Buch eine wertvolle Grundlage für Forschende, Planer und Anwender im Bereich der geothermischen Energie.49,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind effiziente Methoden zur Namensauflösung in großen Datensätzen?
Effiziente Methoden zur Namensauflösung in großen Datensätzen sind Hashing-Algorithmen, die den Namen in einen eindeutigen Hash-Wert umwandeln, um schnelle Suchvorgänge zu ermöglichen. Indexstrukturen wie Bäume oder Hash-Tabellen können verwendet werden, um den Zugriff auf die Namen zu optimieren. Parallelisierungstechniken wie MapReduce können eingesetzt werden, um die Verarbeitung großer Datensätze zu beschleunigen. **
-
Was sind mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen?
Mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen können menschliche Fehler bei der Dateneingabe, unterschiedliche Datenformate oder -strukturen sowie fehlende oder inkorrekte Daten sein. Auch können technische Probleme wie Datenverlust oder -korruption zu Nichtübereinstimmungen führen. Schließlich können auch unterschiedliche Zeitpunkte der Datenerfassung oder -aktualisierung zu Abweichungen zwischen den Datensätzen führen. **
-
Was ist der Unterschied zwischen komprimierten Daten und komprimierten Datensätzen?
Komprimierte Daten beziehen sich auf einzelne Dateien oder Informationen, die durch einen Komprimierungsalgorithmus verkleinert wurden, um Speicherplatz zu sparen. Komprimierte Datensätze hingegen beziehen sich auf eine Sammlung von Daten, die als Ganzes komprimiert wurden, um Platz zu sparen und die Übertragungseffizienz zu verbessern. Ein komprimierter Datensatz kann aus mehreren komprimierten Dateien oder Datenbeständen bestehen, die zusammengefasst wurden. **
-
Welche Methoden können zur Analyse von komplexen Datensätzen verwendet werden?
Zur Analyse von komplexen Datensätzen können Methoden wie statistische Analysen, maschinelles Lernen und Data Mining eingesetzt werden. Diese Techniken helfen dabei, Muster, Trends und Zusammenhänge in den Daten zu identifizieren. Durch Visualisierungen und Datenvisualisierungstools können die Ergebnisse verständlich und anschaulich dargestellt werden. **
Ähnliche Suchbegriffe für Datensätzen
-
Faszinierende Lavaströme (Wandkalender 2027 DIN A3 quer), CALVENDO MonatskalenderErlebe Die Rohe Schönheit Und Gewaltige Kraft Der Vulkane – Bildgewaltig In Szene Gesetzt Durch Künstliche Intelligenz. Jede Darstellung Fängt Die Dynamik, Stille Und Magie Dieser Naturgewalten Auf Eindrucksvolle Weise Ein. Ki Erschafft Dabei...33,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Kompressionsalgorithmen und die Auswahl relevanter Merkmale. Durch diese Maßnahmen kann die Datenmenge reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dadurch wird die Verarbeitungsgeschwindigkeit verbessert und der Speicherplatzbedarf verringert. **
-
"Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?"
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Dimensionalitätsreduktionstechniken wie PCA und die Nutzung von Clustering-Algorithmen zur Identifizierung von repräsentativen Datenpunkten. Es ist auch wichtig, Ausreißer zu identifizieren und zu entfernen, um die Qualität der Daten zu verbessern und die Effizienz von Analysen zu steigern. Letztendlich sollten die gewählten Methoden darauf abzielen, die Datenmenge zu reduzieren, ohne dabei wichtige Informationen zu verlieren. **
-
Was sind die wichtigsten Aspekte beim Monitoring von großen Datensätzen?
Die wichtigsten Aspekte beim Monitoring von großen Datensätzen sind die Überwachung der Datenintegrität, die Performance des Systems und die Sicherheit der Daten. Es ist entscheidend, potenzielle Fehler frühzeitig zu erkennen, um Auswirkungen auf die Datenqualität zu minimieren. Zudem sollte das Monitoring kontinuierlich erfolgen, um eine effiziente Verarbeitung und Analyse großer Datenmengen sicherzustellen. **
-
Wie können Abweichungen in großen Datensätzen erkannt und interpretiert werden?
Abweichungen in großen Datensätzen können durch statistische Analysen wie Ausreißererkennung und Clusteranalyse identifiziert werden. Zudem können Data-Mining-Techniken wie Anomalieerkennung und Mustererkennung eingesetzt werden, um ungewöhnliche Muster oder Trends zu erkennen. Die Interpretation der Abweichungen erfordert in der Regel Fachwissen und Kontextwissen, um die Ursachen und Auswirkungen der Abweichungen zu verstehen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.